在网站访问日志里,正常请求和扫描请求混在一起。有人尝试读取 .env、.git/config,有人连续探测几个配置文件位置,也有人把服务器当成开放代理测试。单条请求可能已经被拦截,但来源换一条路径后,仍会继续尝试。
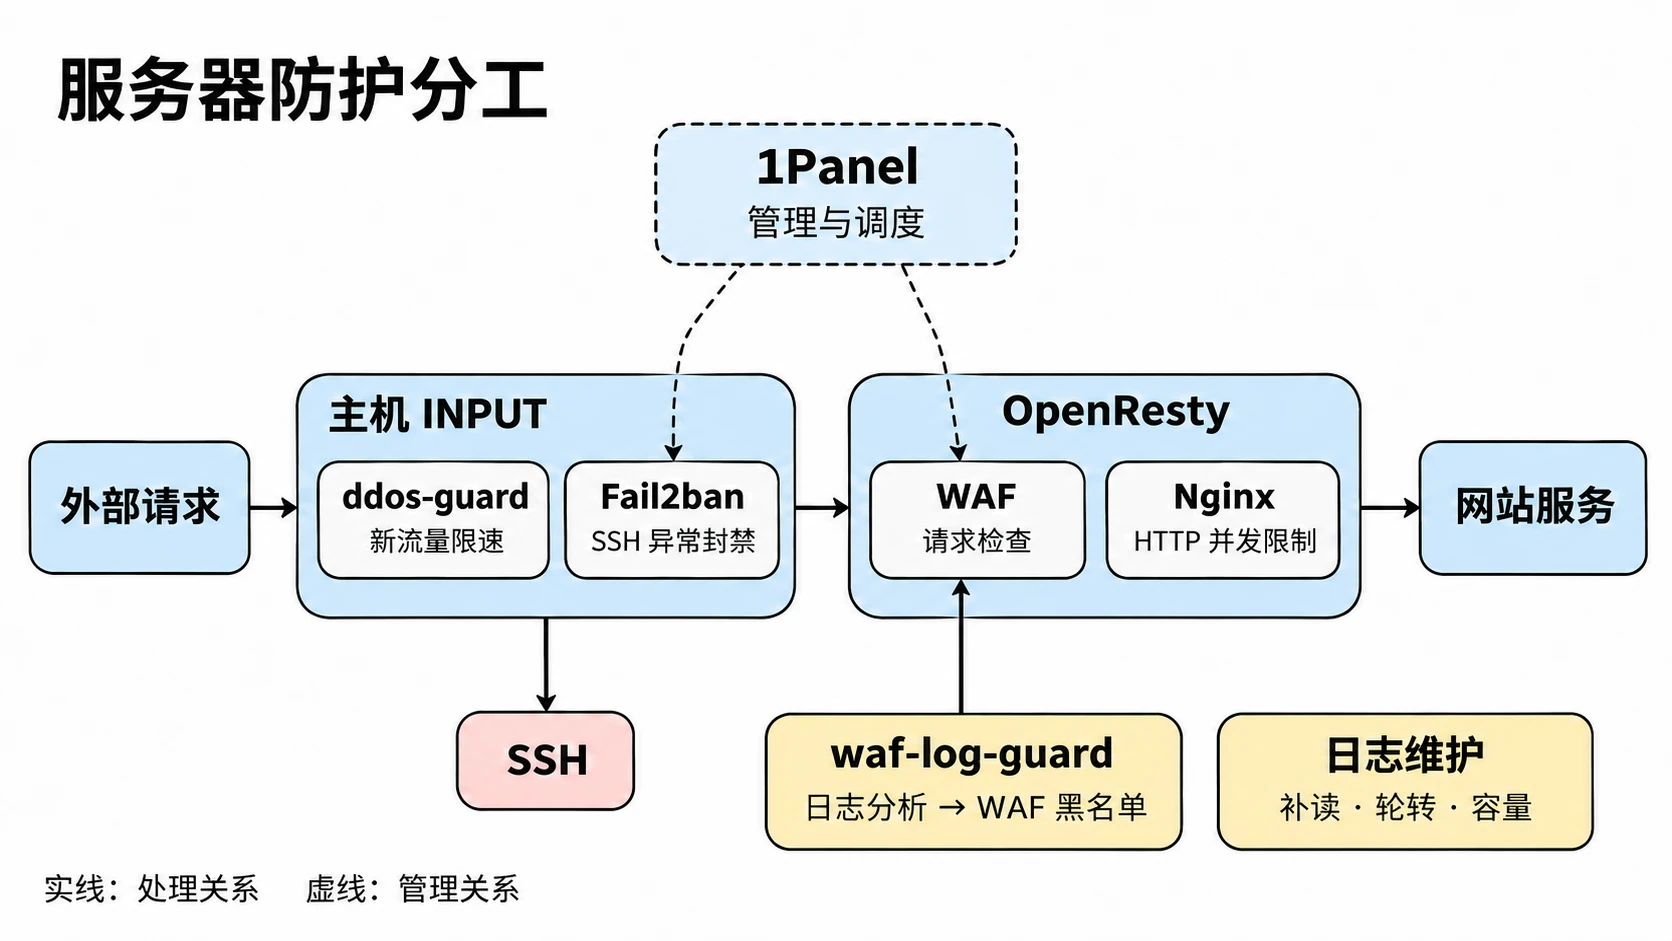
我的服务器运行 Ubuntu,通过 1Panel 管理应用和部分安全配置。整理这些请求时,我把现有防护串成了几层:WAF 检查 HTTP 请求,Fail2ban 处理 SSH 异常认证,内核规则控制新连接相关流量,Nginx 限制 HTTP 并发和登录提交频率,再用自建脚本分析访问日志,把符合条件的来源加入 WAF 永久黑名单。
日志同时也是这些判断的依据。自动封禁依赖它,轮转和容量清理就需要知道哪些内容已经读过、哪些证据还要保留。本文记录这套配置和脚本怎样配合,尤其是规则更新、增量读取和日志轮转里的实现细节。
后来正常打开 Hermes WebUI 时也遇到了 429,我又回头检查了计数范围、页面加载时的请求突发,以及日志到底能证明什么。这次把原来分散的并发配置合到一起,也给登录入口单独加了防刷规则。下面以调整后的实现为主,旧参数和旧日志格式保留在对应的折叠块里,便于回看为什么要改。
先交代功能来源与分工
这里的 1Panel 是管理面板。具体的请求拦截、数据包处理和日志轮转,分别由 OpenResty/WAF、Linux 防火墙、Fail2ban 和 logrotate 等组件完成。
| 部分 | 功能来源 | 我配置或实现的内容 |
|---|---|---|
| WAF | 1Panel 集成的 WAF | 防护模式、请求检查、频率限制与黑名单策略 |
| SSH 异常封禁 | Fail2ban,由 1Panel 集成管理 | 30 秒内命中 3 次、永久封禁及对应动作 |
| 连接限速 | Linux 的 iptables/ip6tables | 自建 ddos-guard,生成、应用和检查限速规则 |
| HTTP 并发控制 | Nginx 的 limit_conn | 每站每 IP 并发 256、单站总并发 512 |
| 登录保护 | Nginx 的 limit_req 与 Tinyauth 原生账号锁定 | 按 IP 限制登录 POST,按账号累计认证失败 |
| 访问日志自动封禁 | 自建 waf-log-guard | 识别行为、保存证据、更新 WAF 永久黑名单 |
| 日志维护 | 自建维护程序结合 logrotate、Docker 和面板原生机制 | 补读与轮转配合、归档容量、审计保留和容器日志限制 |
两项日志任务放在 1Panel 计划任务里调度,程序本身保存在 /opt/1panel/tools/。借用面板调度,便于查看执行结果;判断逻辑、状态文件和错误处理由脚本负责。
下面的参数是这台服务器截至 2026 年 11 月 5 日的配置。代码片段有节选或简化,主要用于解释实现;网卡、端口、容器名和阈值都需要结合自己的部署确认。
WAF:检查请求,也累计异常行为
请求检查与临时封禁分别做什么
当前 WAF 处于防护模式,开启了 SQL 注入、XSS、参数、Cookie、Header 等检查,也启用了默认恶意 URL、UA 和 IP 规则,以及未知站点访问保护。
请求检查处理当前这一条请求;频率与累计攻击策略则会观察一段时间内的行为,超过相应阈值后临时封禁。调整后的相关参数为:
| 配置项 | 统计窗口 | 阈值 | 配置的封禁时间 |
|---|---|---|---|
| CC 访问频率 | 10 秒 | 512 次 | 300 秒 |
| 404 频率 | 10 秒 | 30 次 | 600 秒 |
| 累计攻击次数 | 60 秒 | 10 次 | 3000 秒 |
CC 按“网站+来源 IP”分别计数。同一个 IP 访问两个网站,各自使用本站的 512 次额度;这里的 mode=global 表示同一网站内所有 URL 合并计数,不是整台服务器的所有网站共用一个请求桶。
临时封禁仍按 IP 跨站共享。在一个网站触发封禁后,同一来源访问其他受保护网站也会被拦,避免它换个站点继续打。计数分站、封禁共通,是两个独立选择。这次把普通超频封禁从 600 秒缩短为 300 秒,也是在保留跨站联动的同时,缩短正常访问误触后的影响时间;404 与累计攻击的参数没有随之改动。
旧方案:CC 300次/10秒与原封禁时间(已替换)
最初登记的参数如下。CC 上限较低,普通超频封禁为 10 分钟;这份表只用于记录调整前的状态。
| 配置项 | 统计窗口 | 阈值 | 配置的封禁时间 |
|---|---|---|---|
| CC 访问频率 | 10 秒 | 300 次 | 600 秒 |
| 404 频率 | 10 秒 | 30 次 | 600 秒 |
| 累计攻击次数 | 60 秒 | 10 次 | 3000 秒 |
不能把这张表中的所有数字都理解成整台机器的总流量上限,也不能把 CC 的统计范围套到其他规则上。后面内核层的“全局限速”还有独立计数。
网站开关和正常业务也要核对
配置 WAF 时,我会分别看总开关、网站开关和具体规则。1Panel 文档说明,两级开关需要同时开启;全局设置中标为网站默认值的项目,还需要在已有网站的设置中单独确认[1]1Panel WAF 的启用方式与规则作用范围参考资料。
这次通过 1Panel 原生接口同时更新了全局 CC、已有的 14 个网站和新站默认值,再逐站回读核对。只修改默认值,不能证明已有网站也已经采用新参数。
一次请求被拦截后,排查顺序是请求路径与参数、命中规则、来源地址和网站级配置。正常登录、上传、API、Webhook 等请求也要检查,尤其是带复杂参数或较大请求体的业务。找到具体原因后调整相应规则,白名单只覆盖必要范围。
WAF 的临时封禁到期后会解除。对于访问日志里反复出现的敏感路径扫描,我另外使用 waf-log-guard 进行判定,并追加永久规则。两套机制的证据来源、判断时机和保留方式不同,后面会展开。
Fail2ban:30 秒内命中 3 次 SSH 异常记录
Fail2ban 本身是独立软件,1Panel 提供了管理入口。我使用它的 SSH jail,后端读取 systemd journal,过滤器采用当前安装版本的 sshd[mode=ddos]。
它按过滤规则匹配记录,再在 findtime 窗口内累计来源的命中次数,达到 maxretry 后执行动作[2]Fail2ban 的日志匹配与封禁机制参考资料。因此,“3 次”指过滤器累计的匹配事件,具体会匹配哪些认证或连接异常,要看该过滤器。
我把统计窗口从原来的 5 分钟改成了 30 秒,当前关键配置可以概括为:
1 | [sshd] |
实际配置还包含来源排除名单和动作设置。bantime = -1 在当前配置中表示永久封禁;iptables-allports 的实际动作覆盖该来源的全部 TCP 端口。port = 3322 标明 SSH 端口,但不能据此判断封禁只影响 3322。
这是一项影响较大的策略。我使用密钥登录,并在维护前检查管理来源的排除配置。排查封禁时,可以先看生效参数,再核对规则:
1 | fail2ban-client status sshd |
需要解除某个来源时,经过确认后通过 Fail2ban 操作,例如:
1 | fail2ban-client set sshd unbanip <要解除封禁的IP> |
Fail2ban 的 jail 和 WAF 黑名单各自独立。一次 SSH 封禁不会自动变成 WAF 黑名单记录,反过来也一样;定位访问失败时,需要先确定是哪一层在处理。
连接限速与 HTTP 并发控制
我把 ddos-guard 和 Nginx 并发限制放在同一节,因为它们都处理资源消耗,但统计的是两个维度。
| 机制 | 统计对象 | 当前处理方式 |
|---|---|---|
ddos-guard | 指定服务的新建连接 SYN 包、UDP 443 新流量的数据包速率 | 超限丢包 |
Nginx limit_conn | 已读完请求头且正在处理的 HTTP 请求对应的并发计数 | 超限返回 429 |
ddos-guard 的限速规则由内核执行
脚本目录是 /opt/1panel/tools/ddos-guard/。Python 读取 config.json,生成规则并完成应用、检查和恢复;规则加载后,持续处理流量的是内核。
当前网卡为 enp0s6,网站端口是 TCP 80/443,SSH 为 TCP 3322,UDP 只覆盖 443。IPv4 和 IPv6 分别计数,每个服务类别也有自己的桶:
| 类别 | 每来源速率 | 来源突发额度 | 同一地址族下该类别的总速率 | 总突发额度 |
|---|---|---|---|---|
| 网站 SYN | 50 包/秒 | 100 | 500 包/秒 | 200 |
| SSH SYN | 3 包/秒 | 10 | 20 包/秒 | 40 |
| UDP 443 新流量 | 100 包/秒 | 200 | 1000 包/秒 | 500 |
TCP 统计的是匹配条件的 SYN 包,重传也可能参与计数;UDP 按尚未形成双向通信的新流量处理。表中数值是持续速率与突发额度,令牌桶会随时间补充,实际短时通过量还与桶的当前状态有关。
expected_rules() 为每种类别生成三条核心规则。下面以网站 IPv4 链为例,省略脚本生成的标识后缀等细节:
1 | -A DDOS_V4_SYN_LIMIT -m hashlimit --hashlimit-above 50/sec --hashlimit-burst 100 --hashlimit-mode srcip --hashlimit-name dg4_web --hashlimit-htable-max 8192 --hashlimit-htable-expire 60000 -j DROP |
第一条按来源地址分桶,超过来源额度的数据包在这里丢弃;第二条让仍有总体额度的包返回原有防火墙流程;剩余数据包由第三条丢弃。hashlimit 支持按来源地址分组,limit 提供该规则自身的速率匹配[3]iptables 的 hashlimit 与 limit 扩展参考资料。
这里使用 RETURN,通过限速的数据包还要继续经过原有端口和防火墙策略。来源桶最多 8192 条,空闲 60 秒过期,保存的是短期计数状态。超限只处理当前包,不生成永久黑名单。
入口链还会跳过对回环、RELATED,ESTABLISHED 流量的限速,IPv6 保留已有必要 ICMP 处理。它目前只覆盖主机 INPUT 上、指定网卡与服务的流量;Docker 转发路径和其他端口要看各自的规则。对于带宽已被占满的流量、绕过这些匹配条件的流量,以及完整的 UDP/QUIC 防护,需要另行考虑上游和协议层能力。
更新规则时,只维护自己的链和入口
服务器上同时存在 1Panel、Docker 和 Fail2ban 管理的规则。我给限速工具划定了明确范围:DDOS_V4_*、DDOS_V6_* 以及对应的 INPUT 跳转入口。
apply() 的处理过程如下:
- 读取当前 IPv4、IPv6 filter 表快照,生成本工具的增量补丁。
- 两个地址族先分别执行
iptables-restore --test,通过后再应用。 - 应用使用
--noflush --wait 5,显式更新本工具的链和入口。 - 比较应用前后的默认策略、其他链以及 INPUT 中其他规则,检查是否发生范围外变动;同时确认限速入口处于预期位置。
- 某个地址族失败时,按记录恢复已经应用的本工具规则。
两个地址族按顺序更新,失败恢复也围绕本工具的规则进行。运行时通过文件锁避免本工具重复应用;面对其他防火墙管理器的并发修改,仍需要遵循维护顺序,并在修改后检查实际规则。
成功后,脚本保存配置文件的 SHA-256 和预期规则。再次应用时,配置与规则都一致就返回 unchanged;检查时可以发现“配置改了但没有应用”“规则被其他工具改动”“入口丢失或被前置规则绕过”等情况。
1 | python3 -B /opt/1panel/tools/ddos-guard/guard.py status |
目前没有给它安排每日巡检任务。限速由内核持续执行,开机服务负责加载;更新面板或修改防火墙后,再手动核对状态。
开机恢复,把静态规则和动态规则分开
基础服务 iptables-base-restore.service 在 Docker、Fail2ban、1Panel 和 cron 之前恢复静态 filter 基础规则。/etc/iptables/rules.v4、rules.v6 中只保存基础策略,动态规则随后由各自的管理程序恢复。
基础恢复服务也设置了条件:检测到 Docker、Fail2ban 或 1Panel 已经运行时,跳过整表恢复。ddos-guard.service 则等待相关服务和本机 1Panel agent 接口就绪后,加载自己的链和入口。
保留下来的安装验证记录包含 18 项隔离网络测试和 10 项生命周期测试,覆盖来源与总体限速、类别隔离、规则更新范围和恢复行为。开机恢复是在隔离环境中验证的,记录明确注明没有为此重启真实主机。这些结果说明了规则在所测条件下的行为,不代表真实线路上的抗攻击容量。
正常打开页面,也可能碰到旧的并发限制
这次调整的起点是 Hermes WebUI:正常打开页面时,访问日志里出现了 429。一次打开过程的前 10 秒里,有 272 条请求完成,其中 190 条是 JS 资源请求,另有 API、样式和字体请求;也能看到部分资源先返回 429,随后重试得到 200。
这能说明页面加载存在明显突发,却不能说明实时并发就是 272。访问日志记录的是请求完成事件,旧格式又没有限流结果、上游状态和处理时长,无法把历史上的每一条 429 都准确归因。排查时需要把“10 秒请求数”“正在处理的并发数”和“被拒次数”分开。
旧配置还有一个可以直接确认的问题:来源桶只用 IP 作为键,同一 IP 访问不同网站也会争用同一个 100 并发额度。管理者同时打开几个后台时,一个网站加载资源就可能挤占另一个网站的额度。
旧方案:同一IP跨站共用100并发(已替换)
原先在主配置的 http 层声明共享区:
1 | limit_conn_zone $binary_remote_addr zone=perip:10m; |
再由 http.d/90-connection-limits.conf 设置上限:
1 | limit_conn perip 100; |
按这套配置,同一来源跨网站累计的并发上限为 100,同一虚拟站点为 500。纯 IP 计数没有给不同网站划分独立额度。
排查期间曾给 Hermes 加过独立的 256 并发配置,先让它不再争用其他站点的来源桶。最后统一调整时,我把这份专项配置和代理位置里的覆盖指令都移除了:计数范围应该由统一规则解决,后续维护也能在同一个地方找到上限。
新设计:每站独立计数,再加站点总量保护
现在的并发部分全部放在现有 http.d/90-connection-limits.conf,仍由主配置在 http 层包含:
1 | limit_conn_zone "$server_name:$binary_remote_addr" zone=site_perip_v2:10m; |
第一个键同时包含网站和来源 IP,同一 IP 在不同网站各有 256 的并发额度;第二个键只包含网站,把该站所有来源的并发总量限制为 512。所有网站使用这套配置,Hermes 也继承同样的上限。zone=...:10m 是共享状态区大小,与日志文件大小无关。
计数有具体前提:请求头已经读完,并且请求正在处理。HTTP/2、HTTP/3 中,每个并发请求分别计数;下级配置如果声明了自己的 limit_conn,还会影响继承关系[4]Nginx limit_conn 的计数与继承规则参考资料。
Nginx 的 256 并发与 WAF 的 512 次/10 秒分别约束占用和频率。少量请求如果长时间不结束,也可能占满并发;大量很快结束的请求,则可能在并发不高时先触发频率限制。两个数字不能直接比较,更不能用 10 秒请求数替代同时在途的请求数。
我把 256/512 作为这台服务器的统一起点,为页面资源加载留出空间,也保留单站总量保护。这不是服务器处理能力的测定值。长连接、流式接口和下载仍会占用并发,后续是否调整,要看正常使用时的限流记录和处理时长。
登录 POST 单独防刷
登录页是多个受保护站点的入口,密码提交需要更窄的频率限制。我只给 Tinyauth 的登录 POST 加了一层按 IP 的防刷规则,和并发规则保存在同一个 90-connection-limits.conf 中。下面用 auth.example.com 代指实际登录域名,应用时需要替换成认证站点的 server_name:
1 | map "$server_name|$request_method|$uri" $tinyauth_login_key { |
只有指定网站、方法和路径同时匹配,才会生成计数键;其余请求的键为空,不参与这个登录桶的计数。打开登录页、已有会话的鉴权检查,以及其他网站的普通请求,都不消耗这份登录额度,仍受前面的通用并发与 WAF 策略保护。
10r/m 是持续速率,burst=5 为短时突发留出余量,nodelay 让额度内的突发立即处理,超过后返回 429。这不是固定窗口里的“一分钟最多提交 10 次”;空桶条件下,当前请求加上 5 个突发名额,可以瞬间通过 6 次[7]Nginx limit_req 的速率、突发与空键规则参考资料。
Tinyauth 自己的账号锁定继续保留。当前 v5.2.0 没有覆盖默认值:失败次数阈值为 3,锁定时间为 300 秒[8]Tinyauth 的登录重试与锁定配置参考资料。它按账号标识记录失败,成功认证会清除对应失败次数和锁定时间,不能描述成“每 5 分钟自动重置 3 次机会”[9]Tinyauth v5.2.0 的账号失败计数实现参考资料。
这两层分别限制一个 IP 的提交压力和一个账号的失败尝试。Nginx 登录防刷只拒绝超额提交,不额外写入跨站 IP 封禁名单;账号锁定也不等于 WAF 的共享 IP 封禁。
配置合并后,怎样确认边界真的生效
我先在独立 Nginx 进程和私有共享内存里验证计数边界,再检查生产入口,避免为了测上限直接向真实应用堆并发:
| 检查 | 结果 |
|---|---|
| 同站、同 IP 同时保持 257 个请求 | 256 个通过,1 个返回 429 |
| 同 IP 在站点 A 保持 256 个请求,再请求站点 B | B 仍能通过 |
| 多个来源向同站保持 513 个请求,单 IP 均不超过 256 | 512 个通过,1 个返回 429 |
| 独立进程加载实际 WAF 配置并累计 CC 请求 | 前 512 次不触发,第 513 次触发;封禁 TTL 为 300 秒,换站点仍能读到同一 IP 封禁 |
登录防刷也先做了隔离验证,再用专用回环来源向真实登录接口提交无效 JSON:空桶时连续 8 次,前 6 次到达应用并得到 400,后 2 次由 Nginx 返回 429;同一来源仍能打开登录页,约 6 秒后又有一个提交名额。无效 JSON 在账号查找前被拒绝,这次检查没有使用真实账号试错。
已有 14 个站点的入口及抽查的鉴权接口都进行了核对,配置经 nginx -t 后平滑重载。登录后的 Hermes 完整冷启动和实际长连接使用仍需要浏览器中的正常操作验收,不能由这些边界测试代替。
修改主配置时还遇到一个挂载细节:nginx.conf 是 Docker 单文件绑定挂载,原子替换宿主机文件后,容器可能继续读旧 inode。我在配置校验阶段发现不同步,回退并修复挂载后,改用保留 inode 的原位写入,再校验和重载。后文 WAF 黑名单挂载的是父目录,仍可以使用临时文件加原子替换;两种文件更新方式要结合实际挂载来选择。
访问日志自动封禁:把请求变成可解释的行为证据
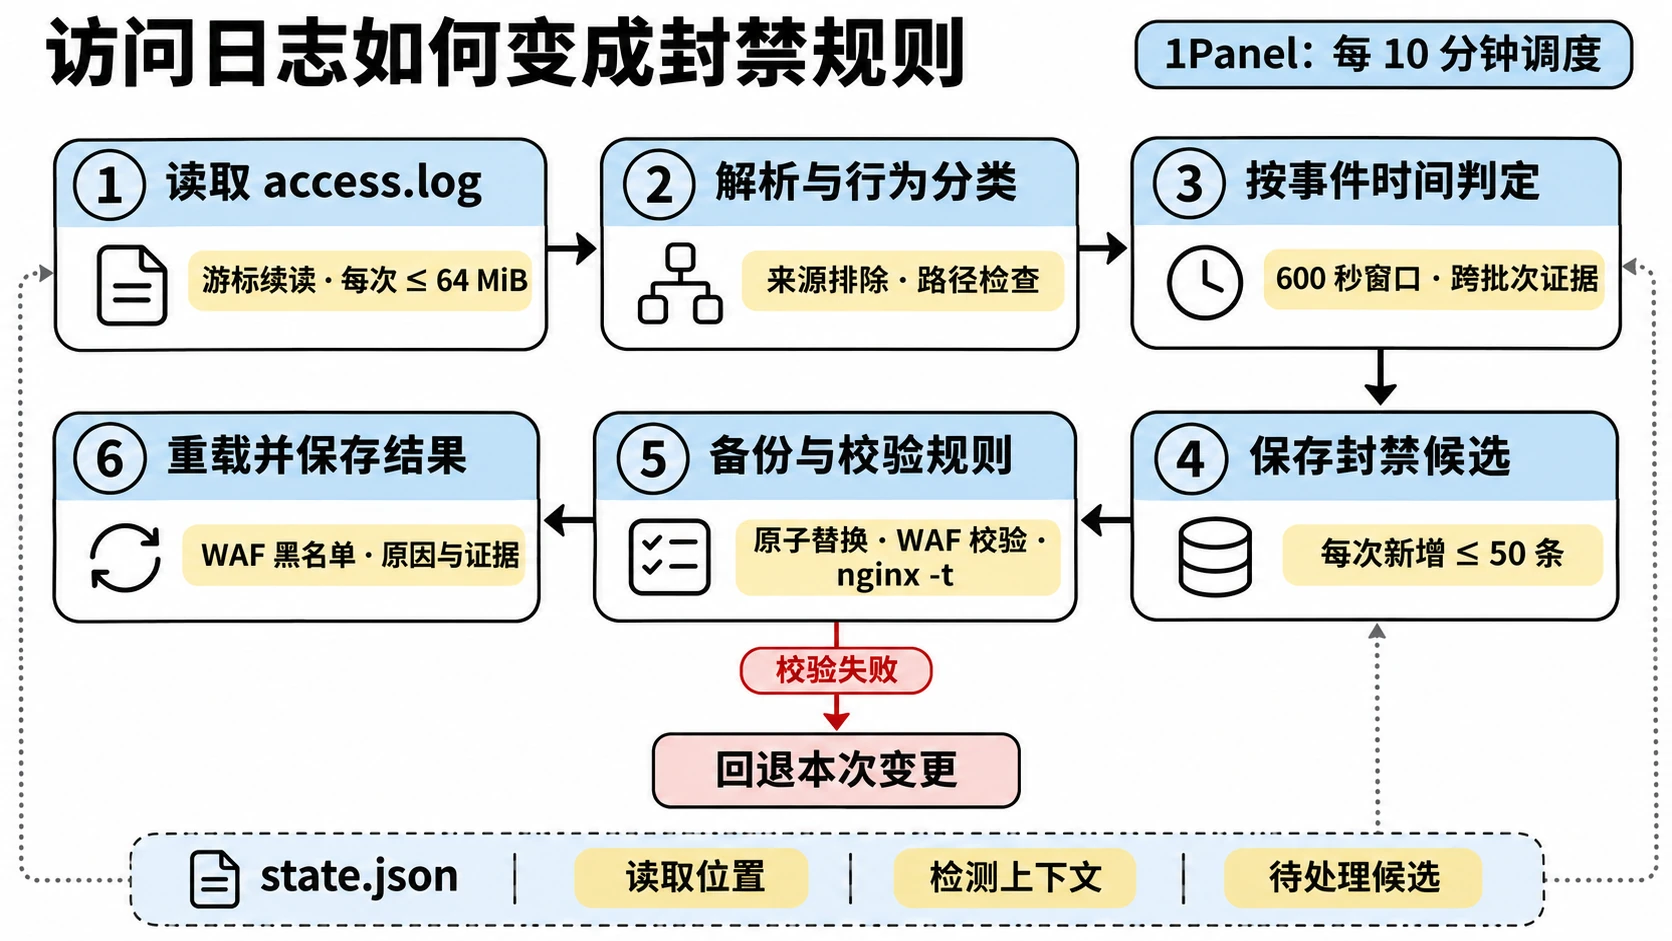
waf-log-guard 读取网站 access.log,在本地判断行为,再更新全局 WAF IP 黑名单。程序集中放在 /opt/1panel/tools/waf-log-guard/,由 1Panel 每 10 分钟执行一次,表达式为 */10 * * * *。
这个任务的输入是访问日志,输出是 WAF 规则和封禁证据。它不修改 iptables,也不要求所有请求先被 WAF 判断为攻击。
先让日志说明请求在哪一层被拒绝
调整阈值之外,这次还要补上排障证据。原来只看到 429 时,我需要在并发限制、WAF 和应用自身之间来回查找;没有对应字段,事后不能仅凭状态码把原因补出来。
旧日志:没有限流与上游归因字段(已替换)
原先的 main 格式记录来源、请求、响应状态和常见请求头:
1 | log_format main '$remote_addr - $remote_user [$time_local] "$request" ' |
它能统计请求量与状态码,但缺少限流结果、上游状态和处理时长。不能据此确认历史上每个 429 的来源,也不能还原当时的精确并发峰值。
现在沿用主配置中的同一个 main 格式,保留原有前缀,只在后面追加字段:
1 | log_format main '$remote_addr - $remote_user [$time_local] "$request" ' |
| 字段 | 排查时看什么 |
|---|---|
host | 这条请求属于哪个网站 |
lc | 是否被 Nginx 并发限制拒绝 |
lr | 是否被 Nginx 请求频率限制拒绝;当前对应登录 POST 防刷 |
us | 上游返回的状态码,区分应用响应与入口直接拒绝 |
rt | 整个请求的处理时长 |
urt | 与上游交互的耗时 |
lc=REJECTED 指向并发限制,再结合错误日志中的 zone 区分每 IP 与单站总量;lr=REJECTED 指向登录提交防刷。如果上游返回了 429,就要继续查应用,Tinyauth 自己的账号锁定也可能产生这种响应。WAF 拦截则回到原生拦截记录里看命中规则,不能只根据字段为空来推断。
这些字段解决的是“谁拒绝了请求、处理花了多久”。按站点和来源可以汇总拒绝次数、比例及持续时间,但它们没有记录实时并发数。上限 256 时,一分钟被拒 100 次,也不代表峰值就是 356。当前先用这些证据判断是否仍有正常访问被拦,精确峰值留给需要容量评估或进一步排障时再采集。
原有封禁解析器只读取日志开头的固定字段,已核对追加内容后仍然兼容,不需要重置已有游标。新增字段也没有改变它的行为判定:被限流本身不直接成为永久封禁依据。
先处理来源和请求目标
解析器按当前 Nginx 日志格式提取来源地址、请求时间、HTTP 方法、目标和状态码。格式不匹配、地址不是公网地址、时间比运行时超前过多的记录会跳过。
当前日志首列使用 $remote_addr,没有通过 real IP 配置改写;脚本也不从 X-Forwarded-For 等头部取封禁对象。经过 CDN 的请求,在这里看到的是代理节点。配置中排除了管理、自检来源及登记的 Cloudflare 节点网段,因此这套规则主要识别能在该日志中获得直接来源地址的请求。
如果要进一步处理代理后的访客,需要先配置可信代理和真实地址恢复,再核对访问日志与 WAF 使用的地址是否一致。单纯开始读取客户端传入的转发头,会改变整个判定的信任基础。代理网段排除名单也需要维护,当前文件中的记录有自己的核对日期。
请求目标的处理分两步:先分开路径和查询参数,再最多解码三轮并转小写。路径以 / 开头时按路径解析,保留 //.env 这类双斜杠形式的扫描特征;其他形式再按 URL 解析。
敏感文件扫描只检查实际请求路径。正常登录参数里带了一个返回地址,即使返回地址中出现 .env 字样,也不会被这一类规则计为扫描。利用载荷规则则按各自条件检查路径或查询参数。
行为分类与阈值
目前程序分成三类处理:
| 类型 | 判断依据 | 成为封禁候选的条件 |
|---|---|---|
scan | 敏感配置、凭据、Git 或特定 AI 服务配置路径 | 连续 600 秒内出现至少 3 个不同敏感路径,或至少 5 条扫描事件 |
proxy | HTTP CONNECT 开放代理探测 | 连续 600 秒内至少 5 条探测事件 |
exploit | 明确匹配脚本中登记的利用载荷特征 | 一条匹配事件即可进入候选 |
状态码保留在证据中,分类和阈值决定是否进入候选。程序会对同一 IP 下的“时间戳、证据路径、类型”组合去重,所以表中的次数是去重后的事件数。
扫描窗口的核心计算可以简化成下面这样:
1 | from collections import Counter, deque |
这里传入的是某一来源已经分类好的扫描事件。正式实现另行处理代理探测和利用载荷,并把判定原因与最近几条证据一起返回。
永久封禁是这套脚本明确选择的策略,判断仍受特征规则和来源识别能力约束。保留原因与请求证据,才能在误封时回到当时的判定过程,调整规则并移除对应黑名单条目。
调度周期与检测窗口分别保存
每 10 分钟运行一次,不代表只处理“运行时往前 10 分钟”的日志。任务延迟后,程序仍需要读取未处理的内容,再按请求发生时间判断是否存在合格窗口。
例如,一组扫描发生在 08:09:58 到 08:10:03,证据可能被分到两次执行中;同样,两个相隔很久的零散扫描,也不能仅因被同一批读到就累计封禁。
状态文件因此同时保存几个部分:
1 | { |
files 保存各日志的读取位置,signals 保存尚需累计的行为证据,pending_bans 保存已达到条件但还未处理完的候选。补读有积压时,保留更早的检测上下文;完成读取后,再按窗口清理过期证据。
每次最多读取 64 MiB,最多新增 50 条封禁。超过读取预算就记录 backlog;超过新增数量的候选继续保存在状态中,后续执行再处理。
增量读取,要识别文件是否还是原来那一个
只存“读到了第几个字节”还不够。日志可能被重命名、截断,路径相同也可能已经换成新文件。
程序为每个活跃日志保存设备号 dev、inode ino、偏移量 offset,以及偏移位置前最多 64 字节的 SHA-256 锚点。再次打开时,文件身份、长度和锚点都符合预期,才从旧位置继续;否则从新文件开头处理。
发生重命名轮转后,活跃路径指向了新 inode。程序会在同名前缀的未压缩文件里寻找旧 inode,先读完旧文件尾部,再转到新文件。旧文件尚未读完时,保留游标并报告积压。
对尚未写完的一行,读取器把位置退回行首,等待后续补齐;异常长记录则设置丢弃状态,跨批次跳到换行结束,避免一条异常记录持续占用读取预算。这些处理让任务可以在固定预算内继续推进。
更新黑名单,有检查、备份和回退
update_blacklist() 读取当前 ipBlack.json,保留现有手工规则,为尚不存在的候选 IP 追加永久条目。执行前检查 WAF 是否处于防护模式,以及 IP 黑名单是否按预期启用。
写入流程为:
- 保存修改前文件及元数据,保留最近 30 份黑名单修改备份。
- 写入前比较文件内容,发现期间已有其他修改就退出,留到后续重新处理。
- 通过临时文件、
fsync和os.replace()更新黑名单,保留原有权限与所有者。 - 在隔离的
resty进程中加载已安装的 WAF 匹配逻辑,检查新增地址是否命中预期的 IP 黑名单拒绝动作。 - 执行
nginx -t,再次确认文件没有变化,然后重载 OpenResty。 - 校验失败且文件仍是本次写入的内容时,恢复原文件并尝试重载;发现其他修改时不覆盖它。
第四步只在独立进程中校验匹配,不会向生产网站发送请求。它检查的是安装版本的 WAF 规则读取与匹配结果,线上端到端效果还要结合实际请求记录确认。
脚本自身通过 flock 避免任务重叠。文件比较可以发现部分外部并发修改,但不能代替所有管理工具共用一把锁。维护黑名单时仍需协调操作时机,并在修改后核对最终内容。
黑名单处理完成后,程序记录封禁原因和请求证据,再保存新的日志游标与上下文。异常路径不会提交本轮游标;下一次可以重新读取。IP 是否已经存在也会重新检查,减少重复追加。
一次真实扫描如何达到阈值
下面来自现有封禁证据,IP 已替换为文档地址,日志行仅节选相关字段:
1 | 203.0.113.10 [05/Nov/2026:08:14:19 +0900] GET /.env.uat 400 |
三条记录在很短时间内覆盖三个敏感路径,达到扫描阈值;08:20 的执行把这个来源加入了 WAF 永久黑名单。这里每条请求的状态码都是 400,判定依据是路径特征与连续行为。
文档地址只用于展示,实际解析器会过滤非公网地址,这组节选不能直接作为程序输入。源码测试使用符合解析条件的地址和完整日志格式。
运行摘要保存在 logs/guard.log,详细证据保存在 logs/bans.jsonl。两类日志分别轮转,每份约 2 MiB、保留 4 份历史。只想查看当前未读内容的判定结果,可以使用:
1 | /usr/bin/python3 -B /opt/1panel/tools/waf-log-guard/guard.py \ |
--dry-run 不修改黑名单和游标。它基于当前未读数据工作,已经处理完的历史案例应查看证据日志;正式执行依赖提前初始化好的状态文件,初始化入口只用于首次建立游标。
日志维护与容量控制:先读完,再轮转
日志维护程序位于 /opt/1panel/tools/log-maintenance/。网站日志与面板审计分别通过 1Panel 在每天 04:10、04:20 调度,时间均为服务器设置的东京时间。
这部分既有自建逻辑,也沿用已有组件:维护程序协调增量读取和 logrotate,Docker 管理容器日志,WAF 拦截日志继续使用面板原生清理。
新的归因字段仍写入原有访问日志,继续使用这套轮转入口。日志列表由站点目录的匹配规则生成,这次刷新列表时也纳入了新增站点,没有为登录限流另开一套日志和调度任务。
轮转前,确认自动封禁已经读完
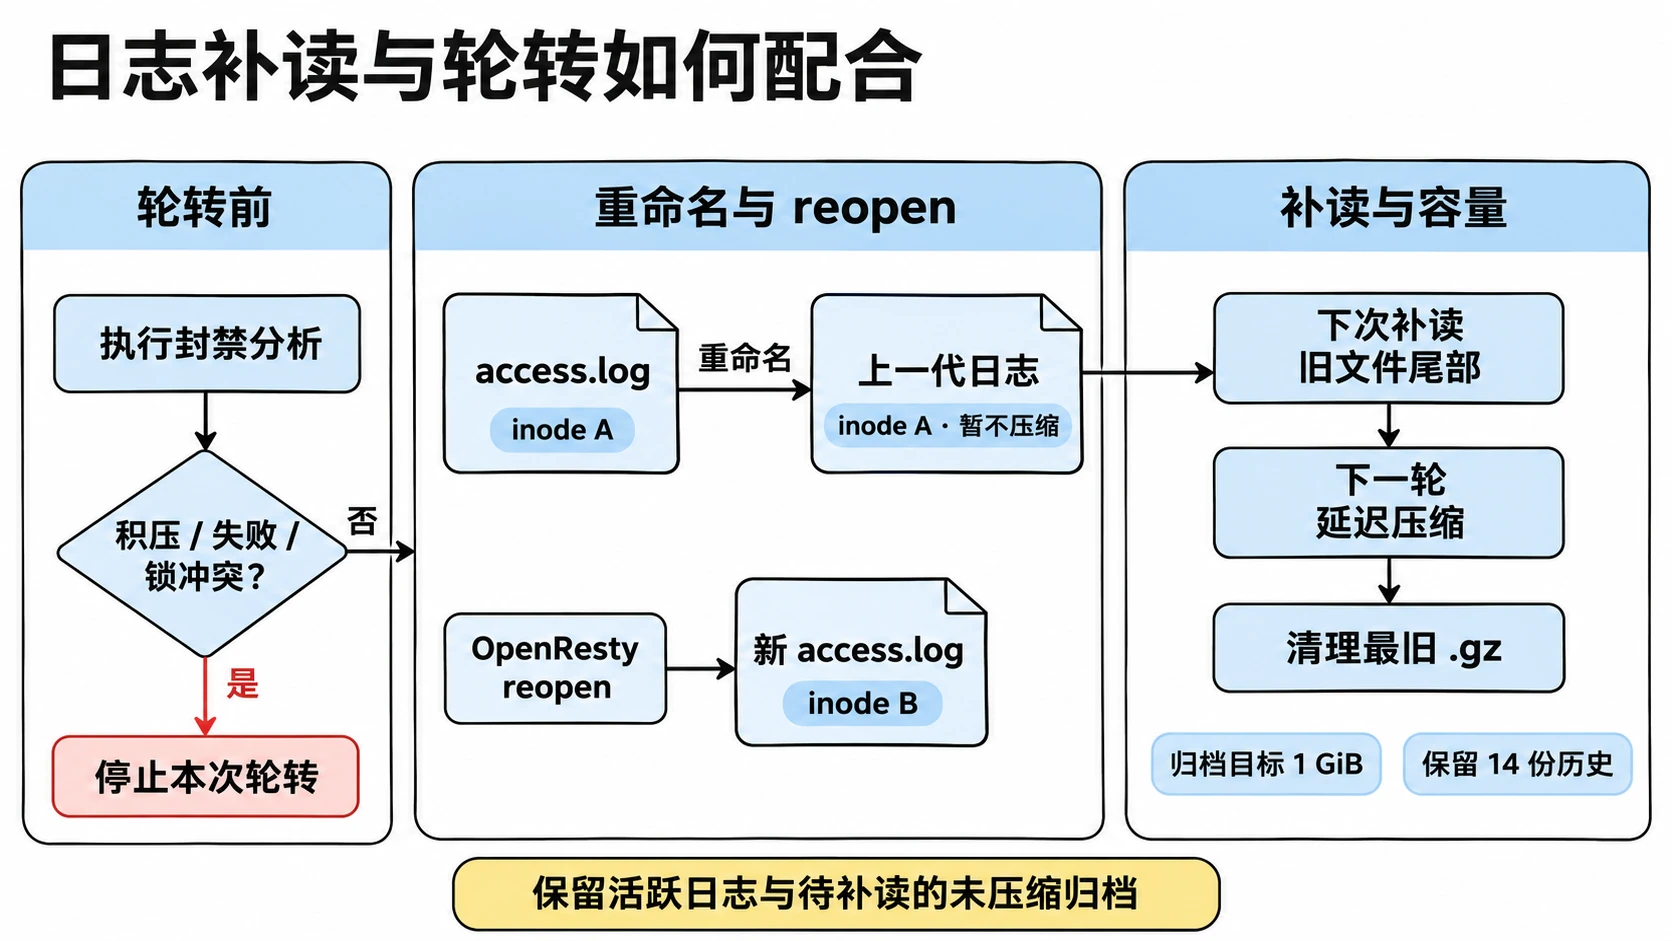
网站维护的处理顺序可以概括为:
1 | 调用 waf-log-guard --apply |
封禁分析失败、仍有积压、没有取得预期输出或发生锁冲突时,本次轮转停止。这样先保留检测所需的输入,下一次再继续处理。
即使轮转前补读成功,新请求仍可能在补读结束后写入旧文件。旧 inode 的追踪、最近一代未压缩日志以及下次补读共同处理这段尾部。
重命名轮转,再通知 OpenResty 重新打开文件
脚本调用 logrotate 执行每日轮转,核心配置如下。具体日志路径和容器名需要使用本机值:
1 | "<网站日志路径>" { |
轮转采用重命名并创建新文件的方式;reopen 让 OpenResty 重新打开日志。delaycompress 把上一代的压缩推迟到下一轮,给增量读取器留下继续打开旧文件的机会[5]logrotate 的延迟压缩机制参考资料。
rotate 14 表示最多保留 14 份历史,notifempty 会跳过空日志。它适合按“轮转代数”理解,实际覆盖时间取决于轮转是否发生。
容量目标要给待补读内容留位置
历史归档总量的目标是 1 GiB。超过后按时间从最旧的 .gz 开始删除,活跃日志和未压缩归档保留。
核心逻辑很直接:
1 | for archive in oldest_first: |
如果仅受保护的文件就超过目标,结果会报告 archive_limit_deferred。因此 1 GiB 是清理目标,需要补读的内容可能使它暂时超额;出现这种情况,应检查积压与增长速度。
面板审计按日期分批清理
面板登录和操作记录保留 90 天。自建程序计算截止时间,使用 SQLite 的 julianday() 比较日期,只删除超过保留时间的记录。
删除按每批 1000 条执行并提交事务,减少长时间占用面板数据库写锁。程序只处理 login_logs、operation_logs,WAF 黑名单另行保存,不受审计清理影响。这段实现依赖当前数据库结构,面板升级后需要重新核对。
预览网站轮转计划和审计清理范围时,可以分别运行:
1 | python3 -B /opt/1panel/tools/log-maintenance/maintain.py website |
这两个入口默认预览,实际变更需要显式传入 --apply。
容器日志由 Docker 维护
大多数容器通过 Compose 持久化了日志限制,例如:
1 | logging: |
Docker 根据这些参数执行轮转。配置变更不会自动应用到已经存在的容器,修改后需要按应用部署方式使其生效,并检查实际容器的 HostConfig.LogConfig[6]Docker json-file 日志轮转与生效范围参考资料。
本次核对时,TinyAuth 使用同等限制,Dayloom 使用 local 驱动并设置了对应的大小和份数;2FAuth 当前运行容器没有显式设置这两项限制。因此这里记录为“大多数容器已限制”,后续维护也需要核对实际状态。
当前日志保留策略汇在一起如下:
| 对象 | 保留或容量策略 | 执行方 |
|---|---|---|
| 网站访问与错误日志 | 每日轮转、14 份历史、延迟压缩;归档目标 1 GiB | 自建程序协调 logrotate |
| WAF 拦截日志 | 当前配置保留 30 天 | 1Panel/WAF 原生机制 |
| 面板登录与操作审计 | 保留 90 天,分批清理 | 自建程序 |
| 多数容器的标准输出日志 | 单份 10m、最多 3 份 | Docker 日志驱动 |
| SSH 日志 | 沿用每周轮转、4 份历史 | 操作系统现有配置 |
| 自动封禁摘要与证据 | 两类分别约 2 MiB × 5 份 | waf-log-guard |
日常检查,从触发它的那一层找证据
维护这套配置时,我主要看三种信息:当前实际加载的规则、执行摘要,以及形成判定的原始证据。
网站返回 429 时,先结合访问日志的 lc、lr、us 判断是并发限制、登录防刷还是上游应用,再看对应错误日志。WAF 拦截核对命中规则和网站配置;来源在 SSH 封禁列表里时,查看 Fail2ban 的匹配记录与动作。如果来自日志永久封禁,就回到 bans.jsonl 看路径、时间窗口和当时的判定原因。
连接限速可以查看链的计数器,并结合脚本检查配置和预期规则是否一致:
1 | iptables -nvL DDOS_V4_INPUT |
计数器记录的是规则命中情况,排查时还要结合来源、流量和服务状态。日志任务则看 backlog、pending、新增条目、轮转执行结果与归档容量,确认它们持续向前推进。
这套实现仍有需要长期维护的地方:永久黑名单没有总量上限,来源排除名单需要更新,阈值会受业务变化影响,面板和 WAF 升级也可能改变配置格式。自建程序保留了检查、预览、状态和卸载入口;后续调整应从具体证据出发,并确认正常业务与已有规则的表现。
参考资料
 微信
- 支付宝