前阵子,我把博客的 SW/PWA、浏览器缓存、阿里云 ESA、传统 CDN 和 PJAX 放在一起,做了一轮比较完整的整理。
一开始只是想让博客访问快一点。以前用过随机背景、随机封面,资源地址经常变化,缓存很难稳定复用。后来图片地址和版本管理逐渐固定下来,长缓存终于有了发挥的空间,但另一个问题也变得明显:页面、样式、脚本分别由不同地方提供,发布新版本时,它们不一定同时更新。
再加上 PJAX 不会每次都重新加载整个文档,旧页面的脚本、弹窗、定时器和异步请求还可能继续存在。只检查首页能否打开,覆盖不到这些交互。
这篇文章记录最终采用的分工:哪些内容适合长期缓存,页面更新怎样被发现,以及切页失败、SW 更新和组件清理怎样配合。配置和验证结果以这次整理时的博客状态为准。
先把访问链路分清楚
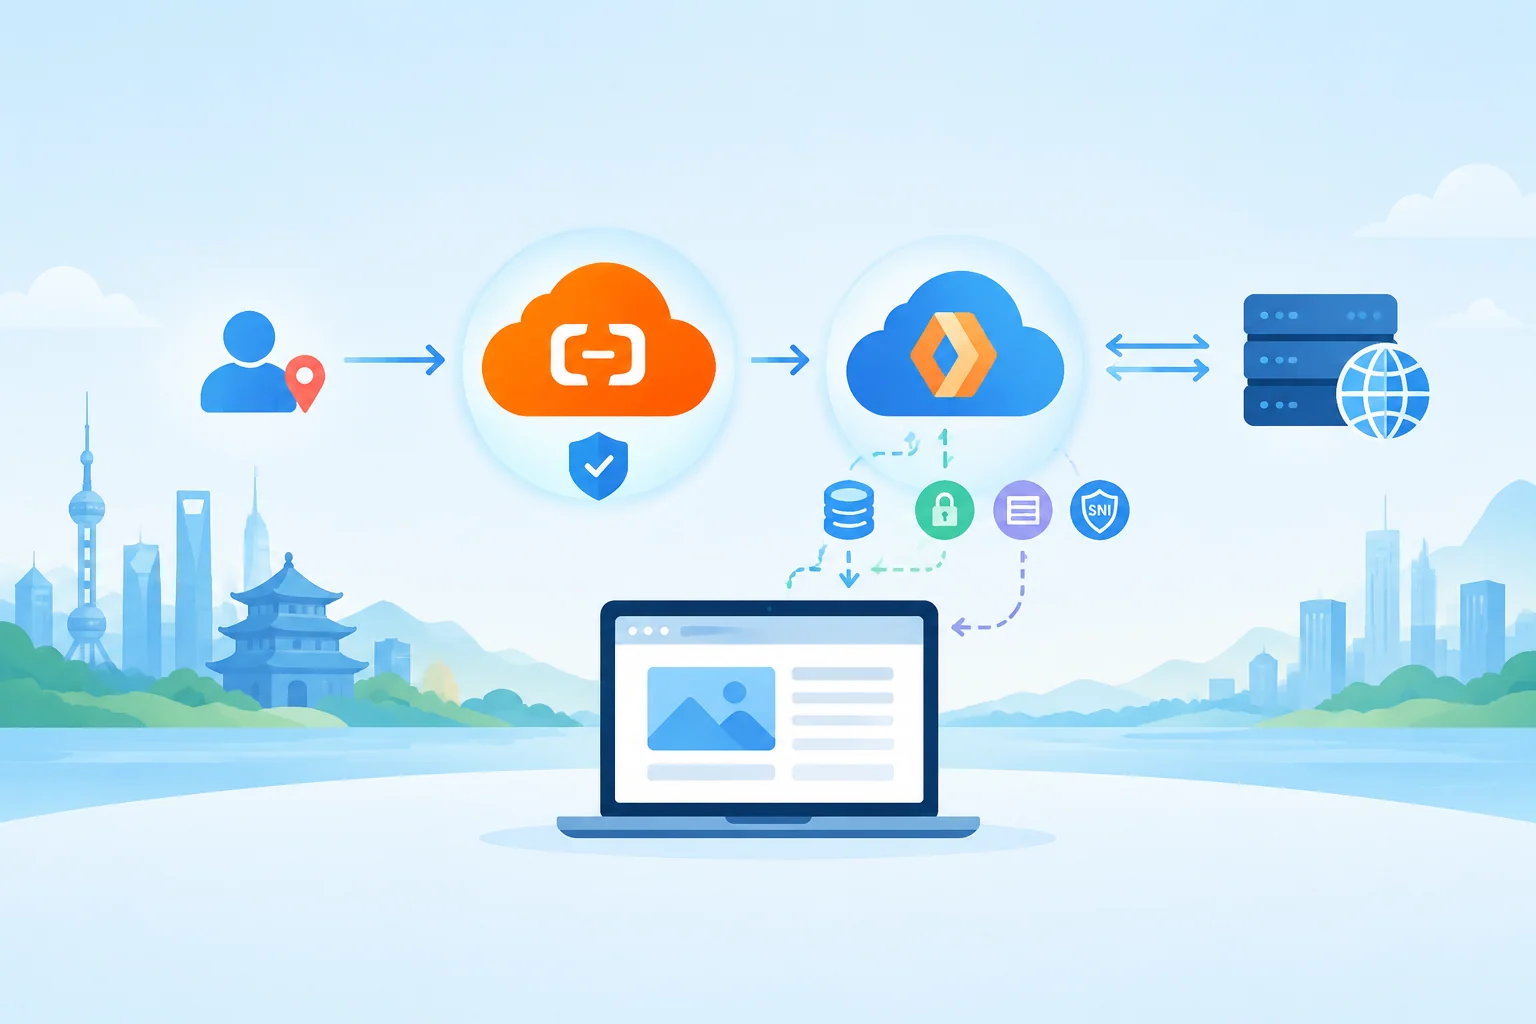
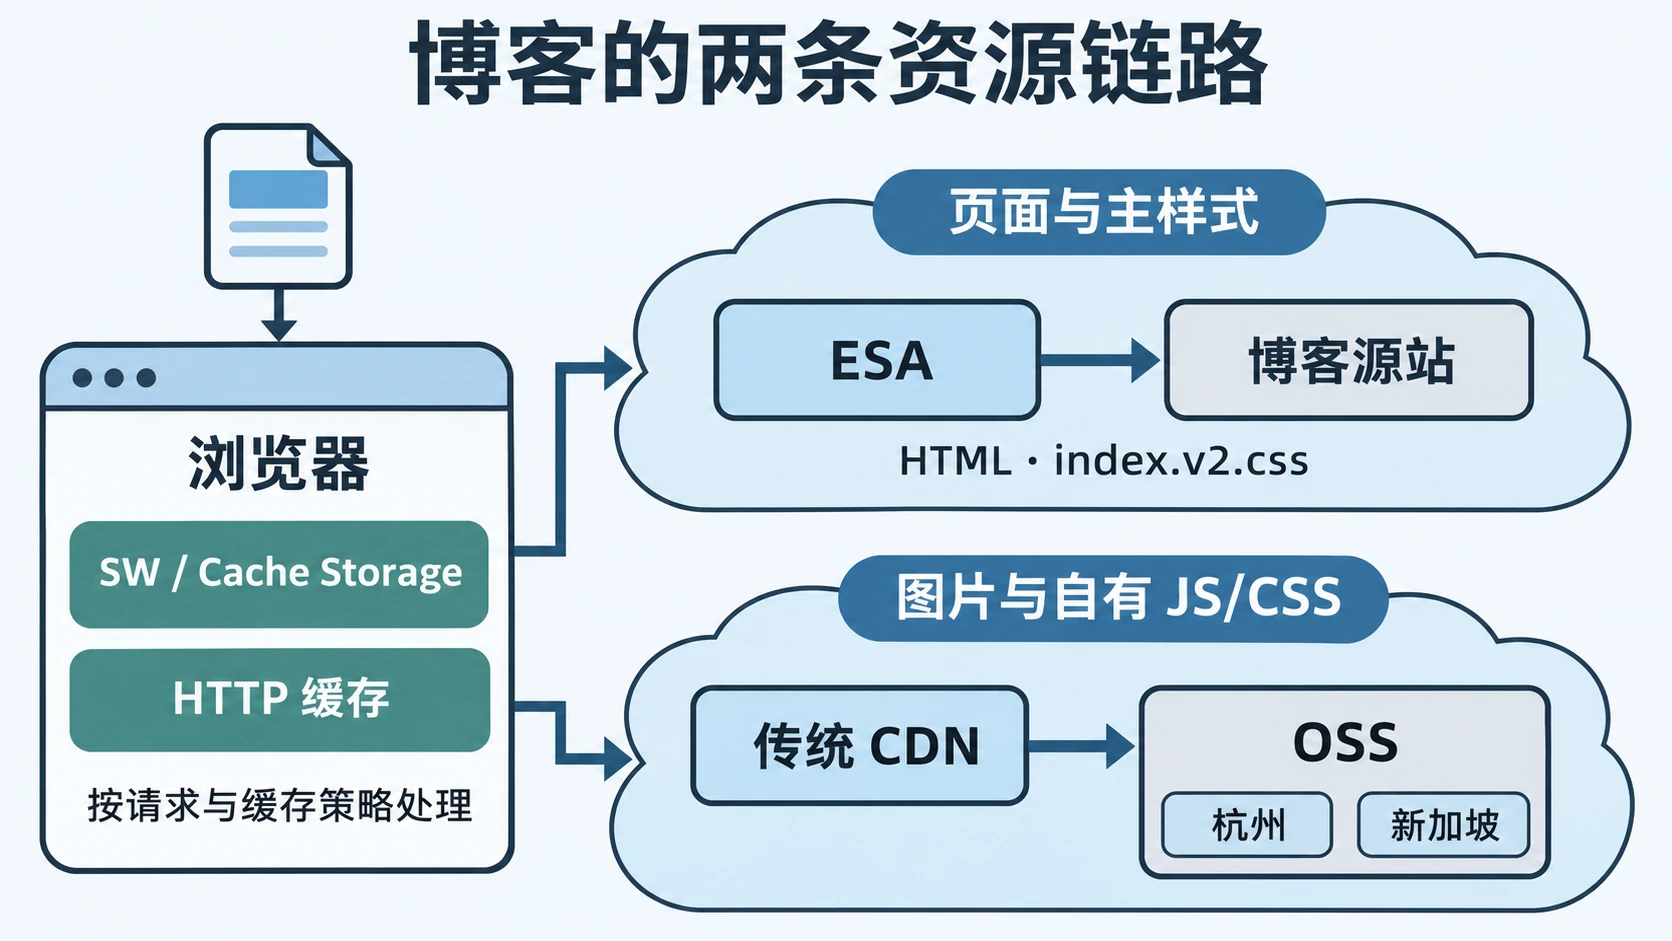
我的博客主要有两条资源链路。页面和主样式位于博客源站,经 ESA 加速;图片及一部分自有 JS/CSS 放在 OSS,由传统 CDN 分发。
| 组成 | 在博客里负责什么 |
|---|---|
| 浏览器 HTTP 缓存 | 根据响应头复用已经下载的资源 |
| Service Worker | 缓存核心文件与已访问页面,检查页面版本,提供离线回退 |
| PWA 客户端 | 注册 SW、检查更新、显示提示,协调用户确认后的刷新 |
| ESA | 缓存和加速博客 HTML、主样式等同源资源 |
| 传统 CDN+OSS | 分发图片和自有 JS/CSS,根据访问地区选择源站 |
| PJAX | 请求目标页面,局部替换文档,并恢复页面交互 |
这里有两个容易混淆的地方。
首先,浏览器 HTTP 缓存与 SW 使用的 Cache Storage 是两套机制。前者由浏览器依据 HTTP 缓存规则处理;后者通过 Cache API 读写,请求是否命中、何时删除,需要应用自己安排。Cache API 本身不会自动遵守 HTTP 缓存头的所有语义[1]MDN:Cache API参考资料。所以,给 HTML 设置 no-cache,并不意味着我写在 SW 里的页面缓存就失效了。
其次,ESA 本身也有边缘缓存能力。我把博客页面交给 ESA,把 OSS 静态资源交给传统 CDN,这是当前站点的部署分工。它们分别服务不同域名,没有必要让每个请求都串行经过两套云端缓存。
SW/PWA:让重复访问更快,也让更新有明确入口
预缓存只保留四个核心文件
这次没有把全站文章、图片和第三方依赖都放进 SW 安装过程。核心预缓存只有四项:
1 | 首页 index.html |
首页和主样式保证最常用的入口,另外两个页面负责错误与离线回退。安装时需要下载的内容比较明确,也不会因为新增几十篇文章,就让每个访客提前下载整站。
预缓存由 Workbox 管理,清单在 Gulp 压缩完成后生成。顺序很重要:先得到最终文件,再计算版本和完整性校验值。如果先计算,后压缩,SW 记录的内容就与最终发布内容对不上。Workbox 的预缓存与版本机制可以参考官方说明[2]Workbox:预缓存参考资料。
文章纳入跟踪,访问后再缓存
构建时,程序会记录每个 HTML 的内容版本和完整性校验值。真正访问某个页面时,再按对应版本读取或写入页面缓存。
已访问页面采用 CacheFirst:存在符合当前版本、仍在保存期限内的缓存时,优先使用本地内容;否则再请求网络。运行缓存单独限制为最多 50 项、最长保存 7 天,避免文章越看越多,SW 就长期保留所有页面。

文章内容和公共页面环境还做了区分:
- 单篇正文变化,更新对应 HTML 的内容版本。
- 公共模板、主题脚本、配置或主样式变化,更新页面的
shell标识。 - 整套 HTML 清单的变化会反映到 SW 发布版本中。
因此,7 天只是缓存保留上限。新版 SW 激活后,会按新清单删除已过时或已不存在的页面条目,不需要等满 7 天才更新正文。
页面进入缓存前还会检查状态码、内容类型和完整性,拒绝不符合预期的响应。已删除或不在清单里的页面继续请求网络,保留真实的 404;无法取得目标页面时,再提供离线回退。没有缓存过的文章和外部依赖,也不能因此承诺完全离线可用。
“更新并刷新”先准备页面,再切换版本
正常更新沿用 SW 的等待阶段,由用户确认后再切换。安装、等待和激活是不同阶段,skipWaiting() 会影响接管时机[3]MDN:Service Worker 的生命周期参考资料。
当前的交互流程是:
- 浏览器发现并准备新版 SW,页面显示“本站内容有更新”。
- 用户点击“更新并刷新”。
- 新版先准备当前页面,或者此前未能打开的目标页面,并校验内容。
- 准备成功后激活新版 SW,再进入对应页面。
- 准备失败则保留当前环境,提供后续重试机会。
这样做对正在阅读、评论或编辑内容的页面更友好。用户还没决定刷新时,页面不会因为后台发现新版本就主动重载;用户明确刷新后,仍需考虑当前输入内容的保存。
更新检查安排在页面恢复可见、重新联网、pageshow 和 PJAX 完成等时机,普通检查有 10 分钟节流。注册时使用 updateViaCache: 'none',避免 SW 更新检查依赖浏览器里旧的脚本缓存。多个标签页之间也通过版本检查与提示协调,防止其中一页更新后,另一页继续把新 HTML 装进旧脚本环境。
浏览器缓存:按资源的变化方式选择策略
HTML 需要验证,稳定资源尽量复用
HTML 承载文章内容和资源引用,更新后需要尽快被发现;图片、脚本和样式只要地址与内容有稳定对应关系,就适合较长的缓存时间。
几个常见响应头的意思,需要先区分清楚[4]MDN:Cache-Control参考资料:
max-age:在规定的新鲜期内,可以直接复用已有响应。no-cache:允许保存,但再次使用前需要验证;它不等同于禁止存储。no-store:要求不要存储该响应。immutable:在缓存仍然新鲜时,表示内容不会变化,减少不必要的重新验证;它不会让文件永远留在浏览器里。
当资源需要验证时,浏览器可以携带 ETag 或修改时间。内容没变,服务端可能返回 304,继续使用原有文件,减少正文传输。验证需要请求,但请求可以由边缘节点处理,不代表每次都得下载整份源站内容。
JS/CSS 的长缓存配合版本地址
20 个自有 CDN JS/CSS 目前使用明确的版本文件名,例如 main.min.v1.js,浏览器响应头为:
1 | Cache-Control: public, max-age=31536000, immutable |
这种配置适合稳定地址。后续需要修改对应文件时,就使用新的版本地址,并修改配置里的链接。只改本地源码,或者只刷新 CDN,都无法替代浏览器已经保存的一年缓存。
封面和插图则沿用已有的地址版本管理,不再额外引入一套命名规则。
主样式也改成独立版本文件
主样式是这次比较容易绕晕的一个细节。之前用过这样的地址:
1 | /css/index.css?__blog_shell=版本A |
查询参数可以区分缓存键,但源站实际仍然只有一个不断被覆盖的 index.css。一旦旧地址的缓存过期或被刷新,再次回源时,就可能拿到已经被覆盖的新内容。旧页面引用和 SW 的完整性校验值仍是 A,返回的文件却成了 B。
现在改成 index.v1.css、index.v2.css,让不同内容拥有独立文件。构建会比较压缩后的最终 CSS:内容相同就复用版本,内容变化再分配新编号,同时更新 HTML 引用、SRI 和 SW 清单。历史 CSS 成品保留在部署仓库,发布时合并进新的部署产物;源码维护版本清单,无需把每份历史成品都堆进样式源码里。
当前页面只引用一份主样式,SW 也只预缓存当前版本。服务器上保留多个文件,不会导致浏览器一起加载它们。原 index.css 则保留迁移前的固定内容,用于兼容旧引用;v1 不会在下一次部署时改名成 index.css。
随机背景与缓存容量
背景选择保存在 localStorage 里的,是地址和模式等少量文本。实际图片仍可能进入浏览器 HTTP 缓存。连续随机切换会下载不同图片,所以“localStorage 没存图片”并不意味着浏览器没有图片缓存。
我保留了背景的长缓存,也没有再让 SW 保存这些图片。普通网页脚本无法可靠地逐项删除浏览器 HTTP 图片缓存,所以“恢复默认背景”只负责重置背景选择,不包装成一个清理浏览器图片缓存的按钮。
缓存容量交给浏览器管理和淘汰;确实需要清理时,再使用浏览器提供的缓存清理功能。强制刷新同样不能当作完整清空 HTTP 缓存、Cache Storage、localStorage 和 Cookie 的统一操作。
ESA:缓存页面,同时给更新留出通道
博客主域名经 ESA 访问。当前全局浏览器缓存遵循源站,边缘缓存优先遵循源站,开发模式关闭;博客再使用三条缓存规则处理关键资源。
| 规则 | 匹配范围 | 处理方式 |
|---|---|---|
blog-update-bypass | /sw.js、/search.xml、/manifest.json | 绕过边缘缓存,浏览器需验证 |
blog-html-30m | HTML 文件与以 / 结尾的目录地址 | 边缘缓存 30 分钟,浏览器需验证 |
blog-css-long | /css/index.css 与 /css/index.vN.css 等版本文件 | 边缘长缓存,浏览器遵循源站 |
这些规则都限定 dingzh.cc,不会把博客策略直接套到其他子域名上。规则与全局继承要一起看,ESA 对默认静态资源、HTML 和目录请求的处理也有区别[5]阿里云:ESA 默认缓存策略参考资料。精简之后,缓存规则占用从五条降为三条,更新入口、页面和主样式各有清晰的范围。
HTML 的边缘缓存与浏览器 no-cache 可以同时存在:浏览器需要验证时,ESA 仍可按边缘策略提供响应。更新入口绕过缓存,也仍然经过 ESA 的访问链路,只是不从边缘缓存中取文件。
另外,博客还有针对静态 HTML 查询参数及共享缓存头的转换配置。当前 HTML 内容不随业务查询参数变化,.html 请求会去掉查询串;这个前提不适用于依赖查询参数返回不同内容的接口。排查时需要连同转换规则一起核对,不能只看缓存规则列表。
CDN+OSS:把稳定资源留在离用户近的地方
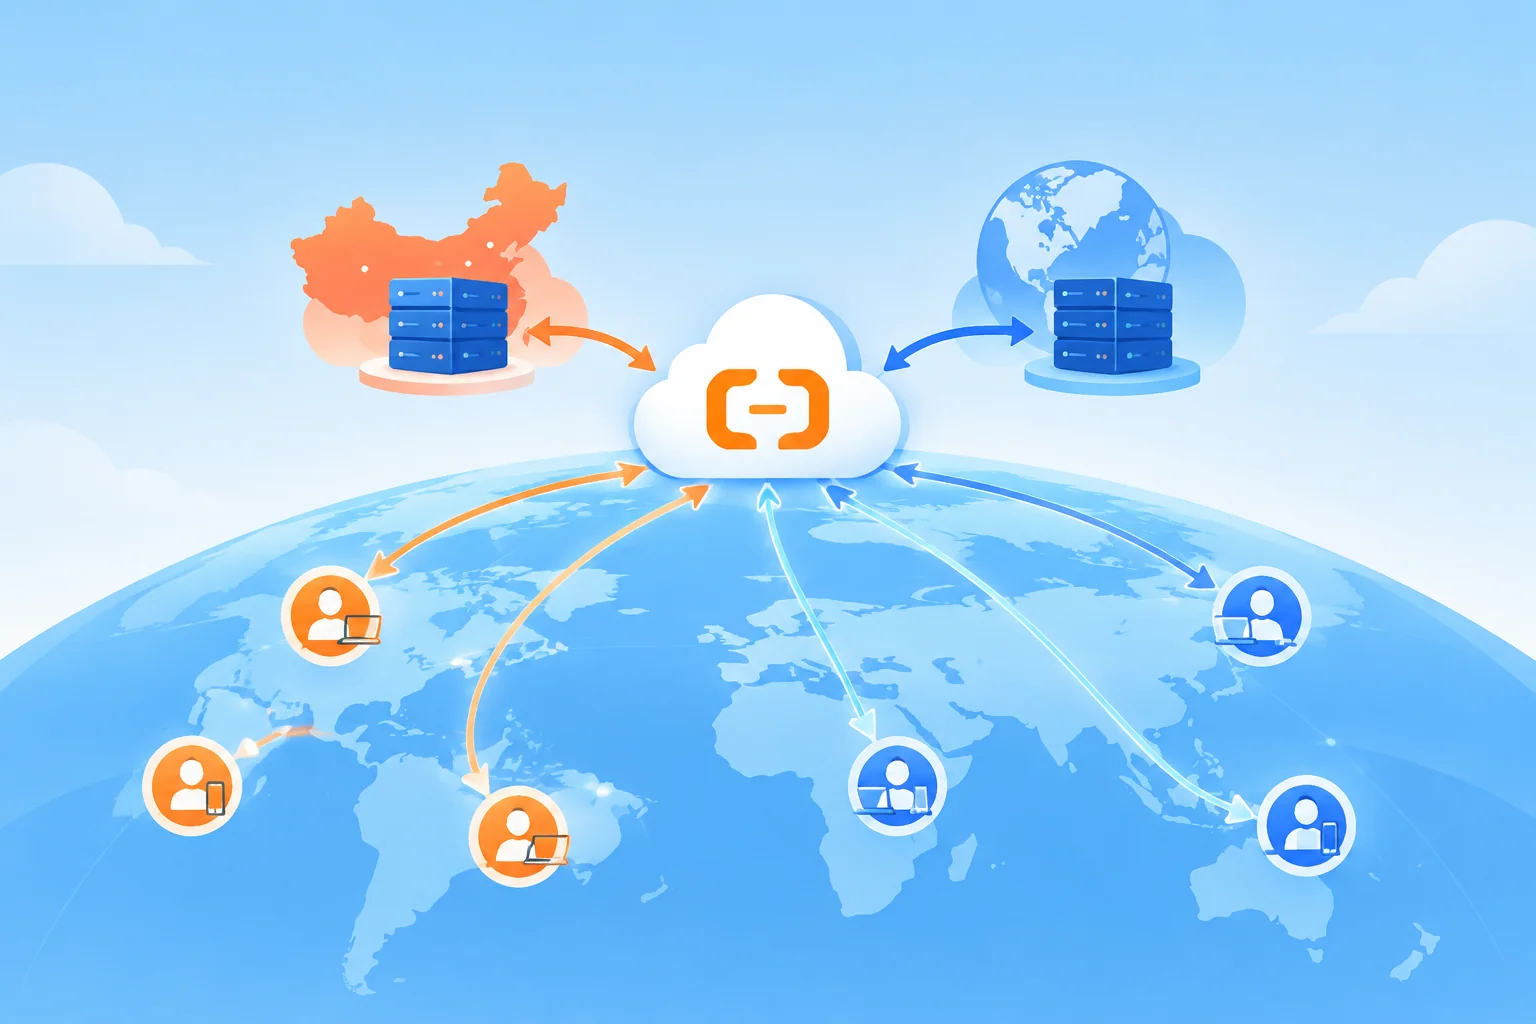
图片和自有 JS/CSS 通过 alicdn.dingzh.cc 分发。区域回源沿用之前配置的国内外双源站方案:中国内地访问回源杭州 OSS,其他地区回源新加坡 OSS,上传后通过现有同步机制保持内容一致。
这里还要核对条件源站与回源 Host,确保访问新加坡源站时使用它对应的 Host。仅仅在列表里添加两个源站,并不能完整表达按地区回源的意图。
最终使用的缓存时长集中整理如下,方便对照浏览器与云端的差别:
| 资源 | 浏览器 HTTP 缓存 | 云端缓存 |
|---|---|---|
| 首页、文章、目录 HTML | no-cache | ESA 30 分钟 |
| SW、搜索索引、Manifest | no-cache | ESA 绕过缓存 |
| 主 CSS | 10 分钟,另由 SW 预缓存当前版本 | ESA 3 个月 |
| 版本化 CDN JS/CSS | 一年+immutable | CDN 6 个月 |
| 封面、插图 | 一年 | CDN 一年 |
| 背景图片 | 90 天 | CDN 3 个月 |
这些时长没有要求必须一模一样。比如浏览器已经保存脚本时,可以直接复用;边缘缓存过期后,再由 CDN 回源重新取得文件。只要版本地址对应内容稳定,这两层就能分别发挥作用。
保留真正参与版本管理的参数
当前 CDN 的参数规则是:缓存键保留 v,回源时保留原始参数。图片的 ?v=… 因而能够区分缓存;文件名里的 .v1 则天然属于路径,不受忽略参数设置影响。
如果把所有查询参数都忽略,图片链接上的版本值就无法区分边缘缓存。阿里云文档也区分了缓存键参数与回源参数,它们控制的是两个环节[6]阿里云:CDN 忽略参数参考资料。
不过,图片查询参数仍不会替 OSS 保存历史对象。需要确保旧页面始终取得原内容的主样式,因此采用了前面的小节所说的独立版本文件。
正常图片与错误响应分开处理
长缓存还需要考虑图片没有上传完成、同步尚未完成或对象不存在的情况。正常图片保存几个月很合适,404 如果同样保存几个月,就会把短暂失败变成长期失败。
这次核对了背景、封面等目录的错误响应。抽测的不存在图片均返回真实 404,缓存头只有 max-age=1,没有继承正常图片的长缓存。图片上传工具则继续读取最终 CDN 地址并核对完整哈希,通过后才回填文章。
JS/CSS 的内容压缩仍在 Gulp 构建阶段完成。云端 HTML/CSS/JS 内容改写保持关闭,避免改变校验所依据的发布产物。这里的内容改写与 HTTP 的 Gzip、Brotli 传输压缩需要区分,不能因为有 SRI 就笼统地认为传输压缩都会导致校验失败。
PJAX:把清理时机放到真正替换页面之前
缓存配置理顺后,花时间最多的是 PJAX 与页面组件的交互。
一次 PJAX 请求至少要区分“请求发出”“请求结束”和“页面成功替换”。请求结束可能是超时或失败,不能把它当成旧页面已经离开。
当前生命周期统一为:
1 | 发起请求:显示加载状态,保留当前页面及组件 |
清理动作放在 PJAX 接受响应、即将替换页面主体的阶段。这样导航失败时,原页面仍然能用,轮播、时钟、随言弹窗也不会被提前销毁。
切页还要确认页面版本
PJAX 请求会携带当前页面的 X-Blog-Shell。SW 在路由前检查版本;客户端也核对响应头或 HTML 中的标识。若新旧环境不兼容,就保留当前页面并提示刷新,不继续局部拼装。
从网络取得页面时,SW 会请求完整 HTML,不向边缘和源站转发 X-PJAX,确保返回内容可以与构建清单进行完整性校验。PJAX 自身关闭随机 cacheBust,避免无意义的随机参数干扰缓存。
失败目标也单独记录:需要重试时知道用户想去哪里;后来已成功切到其他页面,就清除旧目标,避免更新按钮把用户带回早先失败的地址。浏览器前进、后退还要考虑地址栏已先变化的情况,必要时用完整导航恢复地址与正文的对应关系。

组件既要能恢复,也要避免旧回调越界
| 组件 | 这次统一处理的边界 |
|---|---|
| 随言 | 保存、登录、上传等异步回调检查所属页面与实例,旧回调不能操作新页面草稿 |
| 随言弹窗 | 成功替换前再清理,导航失败保留可用节点 |
| Fancybox | 切页前关闭旧灯箱与遮罩,JS、CSS 分别记录加载状态,失败可重试 |
| 移动菜单 | 加载动画结束时保留仍存在弹层的滚动锁,避免菜单开着却能滚动背景 |
| 轮播、电子钟 | 跟随页面清理与恢复,避免失败导航后失效或重复创建实例 |
异步加载与动画也有同样的问题:回调返回时,发起操作的页面可能已经不存在了。因此,“节点还在不在”之外,还要确认节点是否仍属于这次操作。对页面组件来说,可靠的失败恢复与正常切页同样重要。
发布与验证也要跟上这套分工
日常发布仍沿用现有入口。涉及 CDN 文件更新时,先上传新版本并确认同步,再修改配置引用;站点构建完成压缩后生成 SW,发布时保留历史 CSS。需要立即提供新页面,再刷新对应 ESA HTML。

不同刷新操作解决的问题也各有范围:
- PWA 的更新操作负责浏览器中的 SW 版本与页面切换。
- ESA 刷新负责博客域名边缘节点上的相应内容。
- 传统 CDN 刷新负责静态资源域名的边缘副本。
- 浏览器刷新或强制刷新,不等于清除上述所有层。
仅看控制台里的“配置成功”还不够,最后还要读取真正返回的响应。这次线上核对中,116 个 HTML 与 SW 的版本记录一致;20 个版本化 JS/CSS 在两个 OSS 桶中共 40 份对象,与 CDN 返回内容一致。抽查了 28 个 HTTP 响应,6 项条件请求正常返回 304。
浏览器验证还覆盖 PWA 更新、旧缓存条目清理、文章与首页切换、前进后退。此前的本地回归则检查了 PJAX 失败重试、随言草稿、弹层、菜单动画和更新并发等交互。两部分结合起来,才能同时确认资源版本和页面状态。
这些检查验证了资源版本和交互流程。首屏耗时与不同地区的访问速度,还需要在固定网络、设备条件下单独测量。
留下来的几条经验
这轮整理之后,日常维护有了比较明确的落点。文章更新看 HTML 清单和 ESA 生效时间,稳定资源看版本地址,页面交互看 PJAX 生命周期。遇到旧内容时,也能先判断是哪一层在提供响应。
对我这个静态博客来说,长缓存最可靠的基础是地址与内容的稳定对应;SW 的价值在于有边界地复用页面、协调版本;PJAX 则需要把旧组件的退出与新组件的进入安排好。把这些关系理清,后续发布才不必每次都靠清缓存碰运气。
参考资料
 微信
- 支付宝